Publié par : Sophie Robert — Rédactrice spécialisée en intelligence Artificielle
Relu, corrigé et validé par : Guillaume Nicolas — Rédacteur en chef
Le machine learning engineer transforme des algorithmes prometteurs en services utilisables : une recommandation qui répond vite, une détection de fraude fiable ou une prévision capable de s’adapter aux nouvelles données. À la croisée de la data science, du développement logiciel et de l’intelligence artificielle, ce métier consiste à rendre les modèles robustes, déployables et maintenables.
Le machine learning engineer, l’ingénieur qui fait passer l’IA à l’échelle
Le machine learning engineer, ou ingénieur en apprentissage automatique, conçoit et industrialise des systèmes capables d’apprendre à partir de données. Il intervient sur des usages variés : classification de documents, prédiction de la demande, recommandation de produits, analyse de textes, vision par ordinateur, maintenance prédictive ou diagnostic assisté.
Quiz : Machine Learning Engineer
Le machine learning repose sur des algorithmes qui identifient des régularités dans des exemples. En apprentissage supervisé, le modèle apprend à partir de données étiquetées, par exemple pour estimer un risque ou classer un message. L’apprentissage non supervisé sert plutôt à regrouper des profils ou à détecter des comportements atypiques. L’apprentissage par renforcement optimise des décisions successives à partir de récompenses.
Machine learning, deep learning et IA générative : des périmètres différents
L’intelligence artificielle est le champ le plus large. Le machine learning en est une branche centrée sur l’apprentissage à partir des données. Le deep learning est une famille de machine learning fondée sur des réseaux de neurones profonds, particulièrement adaptée à la vision, à la voix et au traitement automatique du langage naturel.
Les LLM, les transformers, les systèmes RAG et les modèles multimodaux relèvent souvent de cette catégorie. Ils ne remplacent toutefois pas les modèles plus simples lorsque ceux-ci répondent au besoin métier avec moins de données, de calcul ou de complexité.
Du jeu de données au modèle surveillé : les missions concrètes
Le quotidien varie selon l’entreprise et la maturité de l’équipe data. Dans une start-up, l’ingénieur peut couvrir une grande partie de la chaîne. Dans une organisation plus structurée, il travaille avec des data engineers, des data scientists, des développeurs backend, des experts métier et des product managers. Ses livrables sont concrets : code versionné, jeux de données préparés, modèles entraînés, API de prédiction, pipelines de déploiement, documentation et tableaux de suivi.
Construire un modèle qui répond à un problème réel
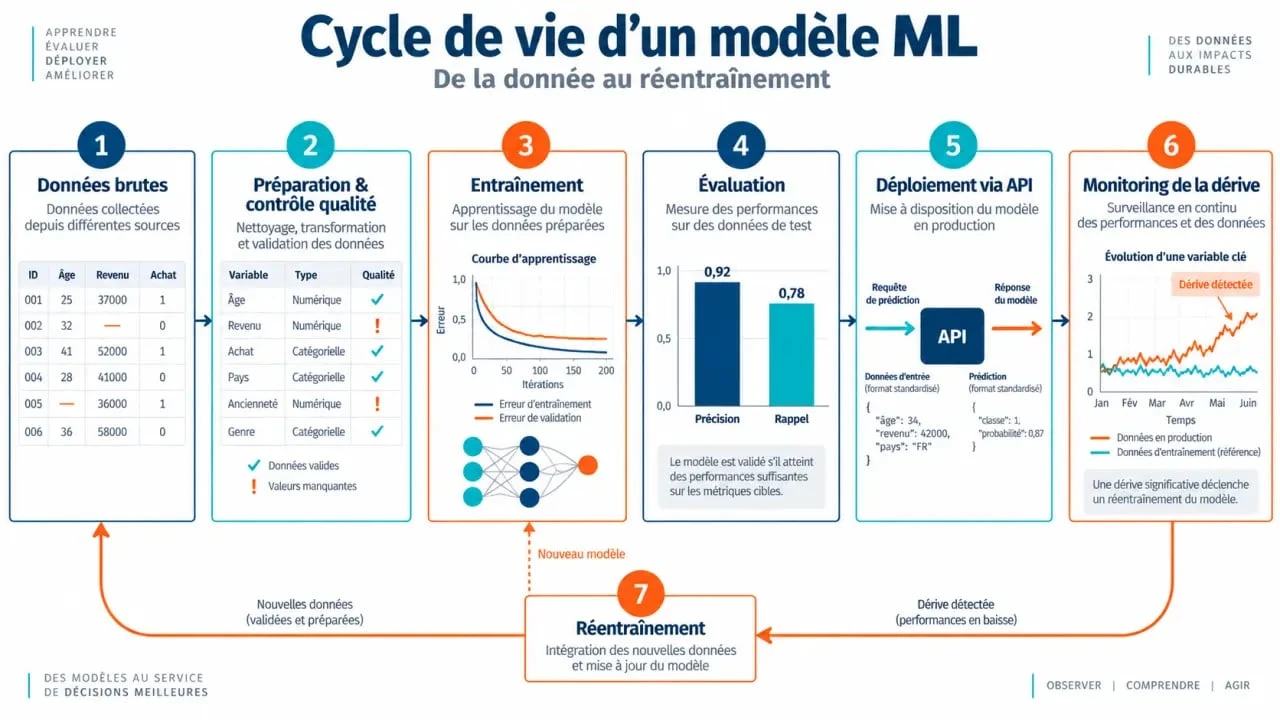
Le travail commence par la définition du besoin : faut-il réduire les faux positifs, améliorer la personnalisation, anticiper une panne ou automatiser un tri ? L’ingénieur collecte ou exploite les données disponibles, les nettoie, les transforme, les normalise et vérifie leur cohérence. Il sélectionne ensuite des variables pertinentes, compare plusieurs approches, entraîne les modèles et mesure leurs résultats avec des indicateurs adaptés : précision, rappel, F1-score, AUC, mais aussi latence et coût de calcul.
Une bonne évaluation ne se limite pas à un score hors ligne. Un modèle peut être excellent sur un jeu de validation et décevant face aux comportements réels, aux données incomplètes ou à un changement de saisonnalité. Il faut donc tester sa robustesse, ses biais éventuels, son explicabilité lorsque la décision est sensible et sa capacité à généraliser.
Déployer, observer et réentraîner
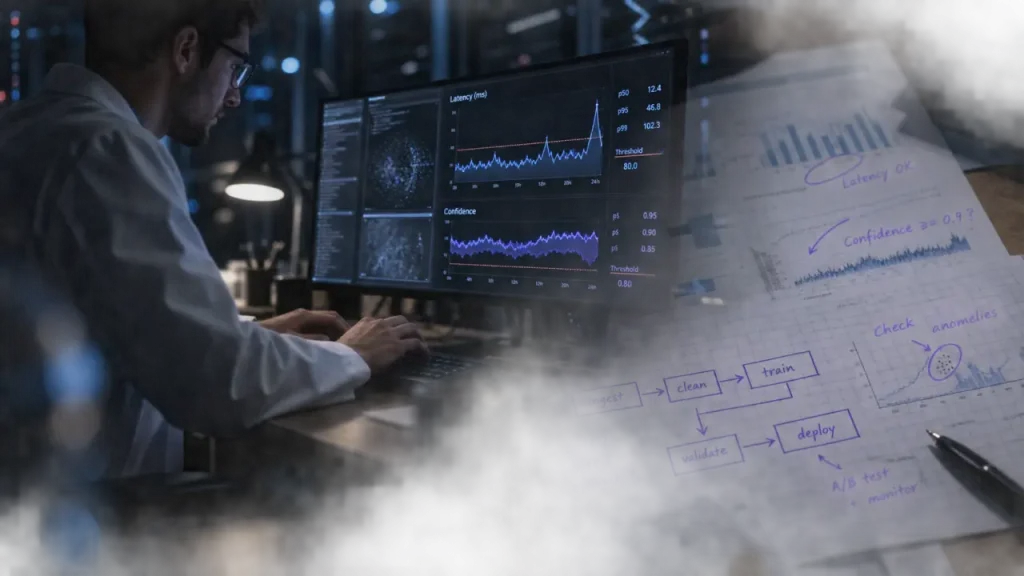
La mise en production passe par une application, une API, un traitement par lots ou un pipeline automatisé. Le machine learning engineer organise le versioning du code, des données et des modèles, met en place des tests, puis prépare l’exécution dans le cloud ou sur une infrastructure interne. Le MLOps relie ainsi développement, déploiement et exploitation grâce à des pratiques de CI/CD, d’observabilité et d’automatisation.
En production, un modèle doit aussi signaler quand il ne répond plus correctement. Un seuil de confiance, une file de revue humaine ou une règle de repli évitent qu’une prédiction incertaine ne se transforme silencieusement en mauvaise décision. Cette gestion du droit au doute est particulièrement importante dans la fraude, la santé, le crédit ou toute automatisation à impact.
Compétences et outils : le socle technique à développer
Python est le langage central du métier, notamment avec Pandas et NumPy pour manipuler les données, Scikit-learn pour les modèles classiques et TensorFlow ou PyTorch pour le deep learning. SQL est indispensable pour interroger et comprendre les bases de données. Spark devient utile lorsque les volumes ou les traitements distribués l’exigent. R, Java ou C++ peuvent compléter ce socle selon les environnements.
Cours accéléré de machine learning par Google · Découvrez les bases du machine learning grâce à des vidéos, visualisations interactives et exercices pratiques.
- Mathématiques appliquées : statistiques, probabilités, algèbre linéaire et notions d’optimisation pour comprendre les modèles plutôt que les utiliser comme des boîtes noires.
- Ingénierie logicielle : Git, code modulaire, tests unitaires, revue de code, documentation et gestion des dépendances.
- MLOps et conteneurs : Docker, Kubernetes, MLflow ou Kubeflow pour tracer les expérimentations, reproduire les entraînements et déployer.
- Cloud : AWS SageMaker, Google Vertex AI ou Azure Machine Learning pour entraîner, servir et surveiller des modèles à l’échelle.
- Qualités professionnelles : rigueur, curiosité, sens du compromis et capacité à expliquer une limite technique à un interlocuteur non spécialiste.
Le bon profil n’est pas nécessairement celui qui connaît le plus grand nombre de frameworks. Il sait choisir une solution proportionnée au volume de données, à la fréquence d’usage, aux contraintes de confidentialité, au budget et au niveau de risque. Un modèle légèrement moins performant mais rapide, compréhensible et simple à maintenir peut avoir davantage de valeur.
Machine learning engineer, data scientist ou AI engineer : qui fait quoi ?
Les frontières diffèrent selon les entreprises, mais la logique de responsabilité reste utile : certains rôles explorent, d’autres alimentent l’infrastructure et d’autres industrialisent. Le machine learning engineer intervient surtout dans le passage fiable entre l’expérimentation et la production.
| Métier | Priorité | Livrables fréquents | Proximité avec le ML Engineer |
|---|---|---|---|
| Data Scientist | Explorer les données et concevoir des modèles | Analyses, notebooks, prototypes, recommandations | Forte : le ML Engineer reprend souvent un prototype à industrialiser |
| Data Engineer | Rendre les données disponibles et fiables | Pipelines, entrepôts de données, flux de traitement | Complémentaire : il fournit l’infrastructure de données |
| AI Engineer | Intégrer des fonctions d’IA dans un produit | Services IA, intégrations LLM, fonctionnalités applicatives | Très proche, avec un périmètre souvent plus orienté produit |
| Architecte big data | Définir l’architecture et la gouvernance à grande échelle | Architecture cible, règles de sécurité, choix technologiques | Complémentaire : il cadre l’écosystème technique |
Le métier convient particulièrement à une personne qui aime autant déboguer un pipeline que comparer des modèles. La réussite se mesure dans l’usage concret du service, pas seulement dans les résultats obtenus dans un notebook.
Formation, rémunération et trajectoires possibles
Un niveau bac+5 est généralement recherché : diplôme d’école d’ingénieurs, master en informatique, data science, mathématiques appliquées ou intelligence artificielle. Un bac+4/5 peut ouvrir des portes si le portfolio démontre un bon niveau pratique. Pour une reconversion, l’objectif consiste à acquérir progressivement les fondamentaux, puis à prouver sa capacité à livrer des projets complets.
Un portfolio qui rassure un recruteur
Un projet convaincant ne consiste pas seulement à entraîner un modèle sur un jeu de données connu. Il montre une chaîne complète : préparation documentée des données, choix de métriques, comparaison de baselines, API de prédiction, conteneur Docker, suivi des versions et dispositif simple de monitoring. Une recommandation, une détection d’anomalies ou un classifieur de textes sont de bons formats, à condition d’expliquer les compromis retenus.
Salaires, secteurs et évolutions
La rémunération dépend fortement de l’expérience, de la localisation et de la spécialisation. Selon Glassdoor, un salaire moyen d’environ 55 600 € bruts annuels en France était annoncé en 2023. Les repères publiés par emlyon situent un débutant entre 40 000 et 55 000 €, un profil confirmé entre 55 000 et 75 000 € et un senior entre 75 000 et 100 000 € bruts annuels. Data Bird indique notamment, à Paris, 42 à 46 k€ pour un jeune diplômé et 59 à 65 k€ pour un profil senior avec cinq ans d’expérience.
Ces montants proviennent de périmètres et de sources différents. Ils donnent donc des repères plutôt qu’une grille unique. Le secteur, la taille de l’entreprise, la localisation et la spécialisation peuvent modifier sensiblement la rémunération.
Les opportunités se trouvent dans la finance, la santé, l’e-commerce, l’industrie, l’automobile, les transports, les éditeurs de logiciels et les services numériques. Les données de l’OPIIEC font état d’une augmentation de 28 % des offres d’emploi entre 2022 et 2023. Avec l’expérience, l’évolution peut conduire vers des postes de Lead ML Engineer, MLOps Engineer, AI Engineer, AI Architect, responsable IA ou expert en NLP, vision par ordinateur et IA générative.
- Machine learning engineer : industrialiser l’IA, du modèle à la production - 27 septembre 2026
- Gestion de projet agile : comment choisir entre Scrum, Kanban et XP pour gagner en efficacité ? - 20 septembre 2026
- CRM gratuit : 5 solutions pour structurer vos ventes sans investissement initial - 19 septembre 2026